
搜索到
161
篇与
的结果
-
 《elisp 每日一练》——buffer属性 前面我们介绍了buffer相关的操作,主要有buffer的获取、创建、删除、设置当前buffer。我们再最开始的时候为了方便理解buffer的概念,让大家将它类比成 char* const 类型,主要用来保存文本数据的缓冲。这条对也不对,buffer是Emacs维护的一个复杂的结构,可不单单是有个缓冲区的指针那么简单。它除了保存了文本的缓冲,也有各种属性。本篇我们将来介绍一些常用的属性背景知识铺垫首先是buffer的名称。我们在创建的时候都会给一个名称,后续也可以根据名称来获取buffer对象。可以说名称似乎就是获取buffer的 primary key。获取名称可以使用 buffer-name ,而修改名称可以使用 rename-buffer。rename-buffer 有一个名为 UNIQUE的可选参数,表示是否允许名称重复,如果允许的话,在重名的情况下会在buffer名称后加上数字后缀,如果不允许也就是值为 nil 的时候,给出重复名称时会报错。buffer-name 可以传入buffer 对象来获取不同buffer的名称,而 rename-buffer 只能修改当前buffer的名称。第二个属性是它关联的文件。一般来讲如果我们希望修改的内容能持久化的保存,需要将buffer与磁盘上的物理文件关联,并在Emacs退出前进行保存。buffer-file-name 可以帮助我们获取当前buffer关联的文件的物理路径。如果我们要修改/设置某个buffer关联的物理文件,可以使用 set-visited-file-name。第三个属性是修改状态。当Emacs打开一个文件时,会将文件的内容加载到buffer中,并将二者进行关联。此时buffer处于未修改或者说干净的状态。如果我们执行操作修改了文件内容,那么此时buffer会变成修改但未保存到文件的状态,或者说是脏页状态。我们手动执行保存操作之后buffer又会恢复干净的状态。如果我们关闭Emacs时,Emacs默认会遍历当前打开的buffer,对于哪些处于修改状态的buffer会弹出提示框询问我们是否需要保存。但是对于那些没有关联到文件上的则省去了询问的过程。我们可以通过 buffer-modified-p 来查看当前buffer 是否被修改了。也可以通过 set-buffer-modified-p 来设置它的状态。第四个属性是只读属性。如果尝试修改它会报错。我们可以通过 buffer-read-only 这个变量来确定当前buffer是否是只读的。例如我们可以写一个简单的函数来判断指定buffer是只读状态(defun my/buffer-read-only-p (bname) (interactive "B输入对应的buffer:") (let ((buffer (get-buffer bname))) (if buffer (with-current-buffer buffer (if buffer-read-only (message "buffer %s 是只读的" bname) (message "buffer %s 不是只读" bname))) (message "未找到指定名称的buffer"))))我们可以通过设置当前buffer的 inhibit-read-only 变量为t来临时的取消buffer的只读状态,例如我们可以尝试通过以下代码清空 Messages buffer(defun my/clear-messages-buffer() (interactive) (let ((message-buffer (get-buffer "*Messages*"))) (if message-buffer (with-current-buffer message-buffer (let ((inhibit-read-only t)) (erase-buffer))))))请注意我们这里使用的是 let 设置的变量值,而没有使用 setq。我们这里实际上创建的是同名的临时变量,用临时变量覆盖了buffer的“全局变量”。在临时变量存在的时候Emacs读取的是这个临时变量的值,此举会短暂性的将buffer修改为可写状态。在代码跳出let的作用域之后临时变量被销毁,inhibit-read-only 又恢复了初始值。而setq 就达不到这个效果。在 Emacs Lisp 官方开发规范中,临时修改只读 Buffer 最标准的做法就是利用 let 绑定 inhibit-read-only练习有了这些基础,我们可以写一个批量保存的小工具。我们可以遍历当前所有打开的buffer,判断buffer是否是修改状态,如果被修改并且绑定到了具体的物理文件则执行保存操作。保存buffer到文件可以使用 save-buffer 函数(defun my/save-all-buffers() (interactive) (dolist (buffer (buffer-list)) (with-current-buffer buffer (when (and (buffer-modified-p) (buffer-file-name)) (save-buffer)))))总结本篇我们介绍了,Emacs中关于buffer的一些常用属性,以及修改它们的函数或者变量。下面我将其列举出来buffer-name 和 rename-bufferbuffer-file-name 和 set-visited-file-namebuffer-modified-p 和 set-buffer-modified-pbuffer-read-only 和 inhibit-read-only
-
《elisp 每日一练》——buffer 操作 在前面关于buffer 的介绍中,我们都是在操作当前buffer。但是Emacs里面有许多buffer,同时也允许我们创建不同的buffer。本篇我们将进入buffer操作的环节。看看如何在Emacs中管理buffer。背景知识buffer的操作与文本操作类似,无外乎也就是增删改查四个大的内容。我们按照这个顺序来介绍。首先是buffer的创建,可以使用 get-buffer-create 来完成,它接收一个buffer 名称的字符串作为参数,如果当前名称的buffer已经存在则直接获取该buffer的对象,否则创建一个新的buffer。如果我们无论如何都要创建新buffer,而不管名称是否存在,可以使用 generate-new-buffer,该函数会无条件的创建新的buffer,如果当前名称的buffer已经存在,它会创建一个带数字后缀名称的新buffer。而如果我们仅仅获取已经存在的buffer,可以通过函数 get-buffer,当buffer不存在时会返回nil删除一个buffer 可以使用 kill-buffer,它接收一个buffer对象或者buffer名称的字符串作为参数,来删除一个buffer。修改buffer,实际上我个人认为分成两个层面,一个是修改buffer的内容,也就是前面我们提到的goto-char、delete-region 之类的文本操作。而另一个就是修改buffer的属性。其中有一个就是修改当前buffer,在这个层面可以使用函数 set-buffer。这里可能要稍微补充一下什么是当前缓冲,用面向对象的角度来讲,我们调用操作对象的方法总的有一个被操作的对象,而C/C++ 中这个对象实际上通过类函数中的this 指针进行绑定。而我们调用 goto-char、insert、delete-region 等函数,操作的是当前buffer,如果我们希望这些函数操作另外的buffer,那么就需要通过 set-buffer 修改默认buffer。一般来讲,我们通过 set-buffer 切换到别的buffer中进行操作实际上是一个临时性的动作,因为用户此时的注意力完全在当前显示的buffer上,我们只会短暂的切换,而后续又会切换回来。因此这里涉及到一个关于buffer的保存和恢复现场的概念。保存和恢复buffer的现场,用的是 with-current-buffer。witch-current-buffer 会切换到一个已存在的buffer,而事后并不会主动清理无效的buffer。也是说我们在使用前要先确保当前buffer存在,然后使用。但是有时候我们仅仅只需要一个临时的buffer,用后直接删除,此时可以使用 with-temp-buffer到此为止我们已经有4个保存和恢复现场的函数了。我们一般的顺序是 with-current-buffer、save-excursion、save-restriction,至于 save-match-data ,用的不如前面一个广泛。查询buffer,我们可以通过 buffer-name 获取指定buffer的名称,它接收一个buffer对象,或者默认获取当前buffer的名称。我们也可以通过 buffer-list 来获取所有buffer 的列表。最后我们判断一个buffer是否有效时可以使用 buffer-live-p练习buffer的内容可能没有之前介绍文本操作时那么详细,因为我觉得buffer比较简单,实际上我们只要理解buffer是Emacs存放文本的一个内存缓冲区,我们的这些操作实际上就是在修改保留这块内存的变量的属性。而且如果读者对一些文本编辑器有一定的了解,会发现大多数文本编辑器都有buffer的概念。本次的练习我们来尝试将用户选定的buffer中的文本拷贝到当前buffer最后面。它经历的流程如下:通过交互式命令让用户输入对应的buffer名称通过名称获取buffer对象,如果对象不存在则输出错误信息切换当前buffer直接通过 buffer-substring 获取整个buffer的拷贝切换回当前buffer调用insert插入对应的文本最终我实现的代码如下:(defun my/append-string-to-buffer(bname) (interactive "B您要拷贝哪个buffer的内容:") (let ((src-buffer (get-buffer bname))) (if src-buffer ;; buffer有效 (let (src-string) (with-current-buffer src-buffer (save-restriction (widen) (setq src-string (buffer-substring (point-min) (point-max))))) (push-mark) (goto-char (point-max)) (newline) (insert src-string)) (message "无效的buffer名称"))))当前例子中的代码还是有一些问题的,例如我们没有判断当前所在的buffer是否是只读类型的。只读类型只是buffer的一个属性,关于buffer中的相关属性将在后面的内容进行讨论。本篇我们介绍的函数如下:get-buffer-creategenerate-new-bufferget-bufferkill-bufferset-bufferwith-current-bufferwith-temp-bufferbuffer-namebuffer-listbuffer-live-p
-
《elisp 每日一练》——阶段性总结与练习 在之前的一系列文章中,我们已经详细介绍了关于文本和光标的一些操作以及对应的API。我们先回顾一下之前介绍的内容前期内容回顾我们先介绍了有关光标位置和移动光标的一些函数:point-min 和 point-maxline-beginning-position 和 line-end-positiongoto-charforward-line以及拷贝对应区域文本的函数 buffer-substring接着又介绍了有关恢复光标位置相关的API函数markpush-mark 和 pop-marksave-excursion而Emacs内部维护 mark 的方式被称为 mark-ring,有关 mark-ring 的函数与变量如下:mark-ringmarker-positionline-number-at-posmarker-buffermark 与 Point 能构成一个 Region,关于 Region 的函数如下:region-beginning 和 region-endactivate-markuse-region-p因为 region 本身不具备区域保护的功能,它无法限制我们仅仅操作某个区间的文本,所以Emacs又提供了 Narrowing 和 Widen 机制。narrow-to-regionwidensave-restriction之后我们正式进入了对文本的增删改查的学习。相关API内容如下:insertdelete-regionsearch-forward 和 re-search-forward 以及反向的 search-backward 和 re-search-backwardmatch-stringsave-match-datastring-matchstring-match-pmatch-beginning 和 match-endreplace-match综合练习本次练习,我们结合之前介绍的相关API来写一个综合性的功能。我们平时在写代码时经常会写各种各样的注释,有些注释有一些固定的写法, 例如我经常写 TODO 表示这部分功能没有加,后面加上, FIXME 这部分实现的比较粗糙,后面在进行重构或者精细化处理。虽然未来大概率就不了了之了,但是留下这些注释显得比较专业(不是)我们现在要做的就是收集 TODO 和 FIXME 开头的这些注释,然后将它们加入到minibuffer 中,显示,在用户选择对应的注释之后跳转到buffer对应的位置(defvar my/todo-mark-list '() "保存全局的todo列表,格式为(SUMMARY-TEXT . marker)") ;; 收集todo/fixme 数据 (defun my/code-todo-list-collect() (interactive) (setq my/todo-mark-list '()) (save-excursion (save-restriction (widen) (goto-char (point-min)) ;;遍历并收集数据 (while (re-search-forward "//\\s-*\\(todo\\|fixme\\):?\\s-*\\(.*\\)$" nil t) (let* ((raw-content (match-string 2)) ;; 准备数据 (m (copy-marker (match-beginning 0)))) (push (cons raw-content m) my/todo-mark-list)))))) (defun my/jump-to-next-todo() (interactive) (save-restriction (widen) (if (null my/todo-mark-list) (message "当前没有待修正的任务") (let* ((selected (completing-read "请选择要跳转的位置: " my/todo-mark-list nil t))) (when selected (let ((target (cdr (assoc selected my/todo-mark-list)))) (push-mark) (switch-to-buffer (marker-buffer target)) (goto-char target)))))))本次的练习,我们分了两个函数,一个用于收集信息,另一个用于在minibuffer 进行交互。在收集信息时我们仍然采用之前的写法,将string 放在CELL的最外层,这样 completing-read 可以正常读取出对应的字符串提示信息并且显示。而后面我们仍然是通过二者的关联性快速执行跳转。虽然我将它称之为综合练习,但是目前我们还有有些内容没有涉及到,比如说修改注释,我们可以做的更复杂一些,将这种注释修改为更加标准的内容。后面我们学习了buffer、file相关的操作之后就可以做的更复杂一些,例如对搜索的结果进行持久化,又或者搜集整个工程中的待办事项。总结到此位置关于操作文本相关的内容我们都已经涉及到了,后面我们会开始进入有关 buffer 和 window 专题讨论相关的操作
-
《elisp 每日一练》——文本插入、删除、替换 对于文本操作的增删改查,我在前一天已经了解了关于查相关的操作。今天我们来了解增删改。背景知识文本增删比较简单,我们只需要确定光标位置,然后调用相关函数即可。文本的增加或者说插入我们通过函数 insert 来执行。它的函数原型如下:(insert &rest ARGS)它用来在光标所在位置之后插入对应文本,从函数定义上,我们知道这个函数后面可以跟一个或者多个参数。也是就是说我们实际上可以一次插入多个字符串。我们需要注意的是光标和mark的变化,插入结束之后,光标位于插入文本的末尾,而mark由Emacs维护,它会随着文本的变化而变化。删除我们使用函数 delete-region 它的函数原型如下:(delete-region START END)它用来删除从 START 到 END 区域内的文本。而光标位置会在原来的基础上减去被删除的字符数。而 mark 因为是由Emacs自己维护的,所以如果 mark 位于 START 之前,那么它的位置不会发生变化,在END 之后,它的位置会相应的减去 END - START 的值。如果在 START 和 END之间,那么它会被放到 START的位置。增加和删除比较简单,光标和 mark 位置的变化也跟我们平时使用编辑器的习惯一致。这个部分稍微复杂一些的操作是修改。一般来讲,修改之前会进行查找并且对匹配上的部分进行修改,所以它天然的就离不开正则表达式。Emacs 中,通过函数 replace-match 来进行。它的函数原型如下:(replace-match NEWTEXT &optional FIXEDCASE LITERAL STRING SUBEXP)它的核心参数为:NEWTEXT : 替换后的新文本FIXEDCASE : 如果为 nil Emacs在替换时采用智能大小写机制。(例如原词是大写,替换词也会自动转大写),如果为 t 会强制按照 NEWTEXT 的原始值LITERAL : 若为 t 则 NEXTTEXT 被视为纯文本,否则允许在 NEWTEXT 中使用 \1 、\2 来引用正则捕获组SUBEXP : 指定只替换第 N 个捕获组,而不是整个匹配项另外在上一篇我们知道,Emacs中匹配结果非常脆弱,它永远只保留最近一次匹配的结果。我们应该即时通过 match-string 获取并保存结果。但是如果我们确实需要在后续再重新获取怎么办?Emacs提供了一个保护现场的函数 save-match-data。到这里我们已经知道了三个保存现场的函数 save-excursion 、 save-restriction 、save-match-data 。练习到这里我们已经可以尝试对文本进行操作了。我们来尝试一下将所有 foo_ 为前缀的函数替换为 my/foo_ 。因为Emacs 中的函数定义以 (defun 开头,所以我们实际上匹配的就是 (defun foo_下面是我的实现(defun my/profix-internal-functions() (interactive) (let ((count 0)) (save-excursion (save-restriction (widen) (goto-char (point-min)) (while (re-search-forward "(defun \\(foo_[a-zA-Z0-9-]+\\)" nil t) (setq count (1+ count)) ;; 用 \1 引用捕获匹配到的函数名称, 参数t表示维持原来的大小写 参数3为nil表示替换的字符串中允许使用 \1 这种来匹配原来的捕获 (replace-match "(defun my/\\1" t nil)))) (message "重构完成,共修改 %d 个函数名" count)))到此我们已经掌握了移动光标和操作文本的大部分操作了。基于此我们就可以完成日常操作文本的任务了。后面我们将对之前的内容进行一个总结,并完成一个基础的小功能。敬请期待!
-
《elisp 每日一练》——文本搜索与正则表达式匹配 前面我们介绍的都是与光标位置有关的东西,都是建立在光标基础上的操作。很多时候我们在完成相关功能时都要借助光标的移动来完成。相信各位读者看到现在已经可以很熟练的通过光标来完成一些简单的工作了。现在我们正式进入文本操作的范畴,文本也是一种数据,数据的操作无外乎增删改查。我们先从查开始基础知识铺垫Emacs中查找主要通过正则表达式。关于正则表达式的详细内容我就不介绍了,如果你写过代码应该对它的概念不陌生。而Eamcs的正则表达式虽然与主流的编程语言在规则写法上略有不同,不过现在有AI的加持,只要说出需求一般AI可以给出准确的正则表达式Emacs 中常用的搜索函数是 search-forward 和 re-search-forward。它们一个是严格的字符串匹配一个是正则表达式搜索。(search-forward STRING &optional BOUND NOERROR COUNT) (re-search-forward REGEX &optional BOUND NOERROR COUNT)它们的参数都是类似的:STRING/REGEX 是待匹配的子串或者正则表达BOUND 表示搜索的截至位置,如果传入nil表示搜索结束位置为buffer的结尾或者指定的 Narrow 结尾NOERROR: 是否进行错误处理,如果为nil的话会进行错误处理,默认的情况下会直接报错崩溃,一般建议是这里设为 tCOUNT : 表示要跳转到后面第几次匹配的位置, 如果为负数的话会向前查找。对于这两个函数,我们需要注意下面几点:光标移动的“副作用”,它会将光标跳到匹配文本的末尾BOUND 表示的是搜索结尾的位置,那么它的开始位置是在哪呢?它的开始位置是光标当前所在区域。或者是当前Narrow区域的开始位置。COUNT 为负值时光标会停留在匹配文本的开头,类似于调用 search-backward 和 re-earch-backwardsearch-backward 和 re-earch-backward 函数中如果参数为正值,会向上找并将光标放置于匹配文本的开头。为负值的行为与 search-forward 和 re-search-forward 相同匹配到的文字我们可以通过 match-string 来获取。它的原形如下:(match-string NUM &optional STRING)理论上讲,采用精确匹配的情况下,我们已经知道了匹配得到的字符串是什么了,不需要额外的获取,但是Emacs还是在 match-string 函数中给这种情况提供了支持。NUM如果我们使用精确匹配的方式一般填写0就好了,因为0代表获取完整匹配的字符串,而填入1、2、3这样的数字用来获取正则表达式中第 N 个捕获组(括号 ( ... ) 内匹配的内容)。STRING 是一个可选的参数,如果我们上一次匹配是从buffer中进行的,那么这次我们可以在这个位置给 nil 或者默认,如果是在一个字符串中执行了匹配,那么我们需要填写上次匹配的字符串。这个函数还需要注意:该函数不执行匹配操作,永远只获取上一次执行匹配的结果。所以我们在执行匹配之后保存结果之前不能再次执行匹配否则之前的结果会丢失。执行完匹配之后除了可以自己写代码进行保存之外,Emacs还提供了宏 save-match-data 用来保存之前执行匹配的结果。既然我们上面说,match-string 可以获取上次从字符串中执行匹配操作的结果,那么怎么利用字符串执行匹配操作呢?Emacs提供了函数 string-match。(string-match REGEXP STRING &optional START)它的函数原形就简单很多了。这里就不细说了。需要注意,Emacs并没有为精确匹配提供类似的函数。实际上通过正则表达式也可以执行精确匹配。如果你不想获取匹配结果只想知道是否能有匹配结果可以通过函数 string-match-p,与 match-string 相比它少了将匹配结果保存的操作,效率更高一些。匹配相关的函数我们都介绍的差不多了,接着再介绍一下匹配时与光标有关的函数。match-beginning 可以获取匹配项起始位置,它接收一个整数参数,参数的含义与 match-string 中的相同match-end 可以获取匹配项结尾位置的Point,它接收一个整数参数,参数的含义与 match-string 中的相同练习有了这些函数,我们来写一个能循环匹配的查找函数。所谓的循环匹配就是匹配到最后一个之后能跳转回来从开头位置继续匹配。并且我们希望匹配时将光标置于匹配字符串的开头位置。这里为了简单,我使用search-forward 精确匹配作为演示(defun my/search-forward-loop(regexp) (interactive "sSearch regexp (loop):") (save-restriction (widen) ;;全局查找,需要取消之前设置的narrowing 限制 (let ((start-point (point))) ;; 这里需要保留光标移动,只有在未找到时才恢复 (when (looking-at regexp) ;; 如果光标已经在匹配位置的开头,需要移动到下一个,防止一直匹配同一个位置的尴尬情况 (forward-char 1)) (if (search-forward regexp nil t) (goto-char (match-beginning 0)) ;; 未找到,尝试跳转开头,重新查找 (progn (goto-char (point-min)) (if (search-forward regexp nil t) (goto-char (match-beginning 0)) (goto-char start-point)))))))总结本篇不涉及什么Emacs的处理机制,就是简单的一些函数介绍,这些函数我们在其他编程语言中或多或少都见过或者用过。所以本篇实际就是一篇无聊的摘录相关函数的东西。本次介绍的函数如下:search-forward 进行向后的精确匹配search-backward 进行向前的精确匹配re-search-forward 进行正则表达式的向后匹配re-search-forward 进行向后的正则表达式匹配match-string 获取匹配结果string-mach 使用字符串进行匹配string-match-p 判断当前是否有匹配结果match-beginning 获取匹配结果的起始位置match-end 获取匹配结果的结束位置
-
《elisp 每日一练》——Narrowing与Widen 在前面我们介绍了Region的概念,它就是由 marker 和 point 构成的一个区域。Region 是一种极度临时的状态——我们可以通过移动光标随时修改它的区域,或者激活/取消激活。光标可以随意移动出Region所在区域,以后如果基于这个条件进行操作时容易造成误操作Region 可以说只有在激活那一刻才有效,后续如果改变了point 或者 marker 就会造成改变为了应对这些问题,Eamcs中又有了 narrowing和widen 机制。它能将 Buffer 的可视与操作范围强制限制在特定区域内,为你提供一个安全、持久的局部编辑“沙盒”。背景知识铺垫Emacs 中允许我们通过 Narrowing 机制将注意力只集中在 Buffer 的某一部分,而把其余所有的文本暂时“隐身”。这样即使某些操作全局的函数此时也只能操作该范围内的文本。首先,Narrowing 会改变 (point-max) 、(point-min) 的值,在默认没有 Narrwoing 的情况下, point-min 总是返回1,而 point-max 返回buffer中最后一个字符所在的索引。但一旦对 Buffer 施加了 Narrowing, point-min 、point-max 的值就与我们设置的可见区域的区间有关了。我们可以通过 (narrow-to-region START END) 将buffer的可见区域设置为从 START 到 END之间的区域。通过 (widen) 来解除所有之前设置的 narrowing。实际上于 mark 、point 类似,对于 Narrowing 我们也要考虑备份和恢复现场的情况,保存和恢复现场使用的函数是 save-restriction。在一些插件的代码中我们经常看到 save-restriction 和 save-excursion 成对出现。它们的用法也是类似的。既然它们一般是成对出现的,我们不妨考虑一下它们两个谁在外层,谁在内层呢?假如 save-restriction 在外层,而 save-excursion 在内层, 也就是这样;; 假设当前光标位于位置 (Point = 400) (save-restriction (save-excursion (widen) ;; 暂时恢复可见区间为整个buffer (narrow-to-region (point-min) 200) (goto-char (point-max)) ;; 执行其他操作 ))上述例子中,我们通过 narrow-to-region 将可见区域限制在 1 到 200 这个区间。然后执行一些操作。当要恢复时先调用 save-excursion 尝试恢复光标位置到最初的 400时发现它的可见区域最多到200,此时光标位置可能被置于200位置。最后执行 save-restriction 恢复可见区域,但是此时光标已经回不到最初的 400位置了。从上面可以看到最好是将 save-excursion 放在外层。练习本次的例子,我们实现一个简单的统计指定行中单词的个数。这次用到的函数为 count-words , 它的原形如下:(count-words START END &optional TOTALS)它主要接收两个参数:统计的起始位置和结束位置。获取行的区间坐标可以通过 forword-line 移动光标到指定行,然后通过 line-beginning-position 和 line-end-position 获取行首和行尾位置的 point值利用今天所学的内容可以写下如下的代码:(defun my/count-words-in-line(line) ;; 获取行首和行尾位置 (save-excursion (save-restriction (widen) ;; 先取消之前所设置的可见区间恢复整个buffer可见 (goto-char (point-min)) (forward-line (1- line)) ;; 移动到对应行 (narrow-to-region (line-beginning-position) (line-end-position)) (count-words (point-min) (point-max)) )))总结本次我们了解了 Emacs 中的 Narrowing与Widen 机制。后面我们写代码操作文本时可以先直接默认操作整个区域,而在需要关注操作区间时通过 narrow-to-region 设置可见区间。不过不要忘了通过 save-restriction 恢复之前设置的可见区间。本次我们介绍的api函数有:narrow-to-region 设置可见区间widen 取消之前设置的所有可见区间save-restriction 恢复调用之前的可见区间
-
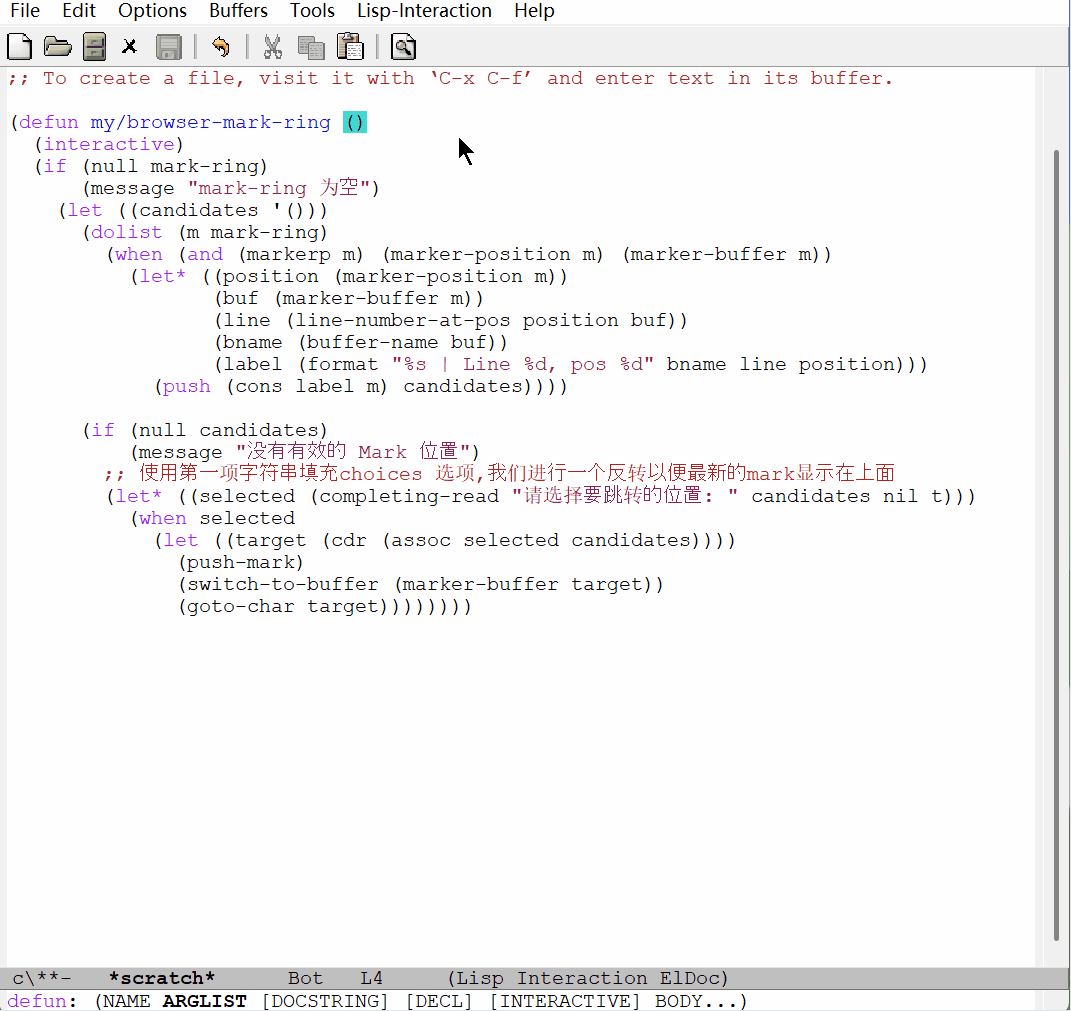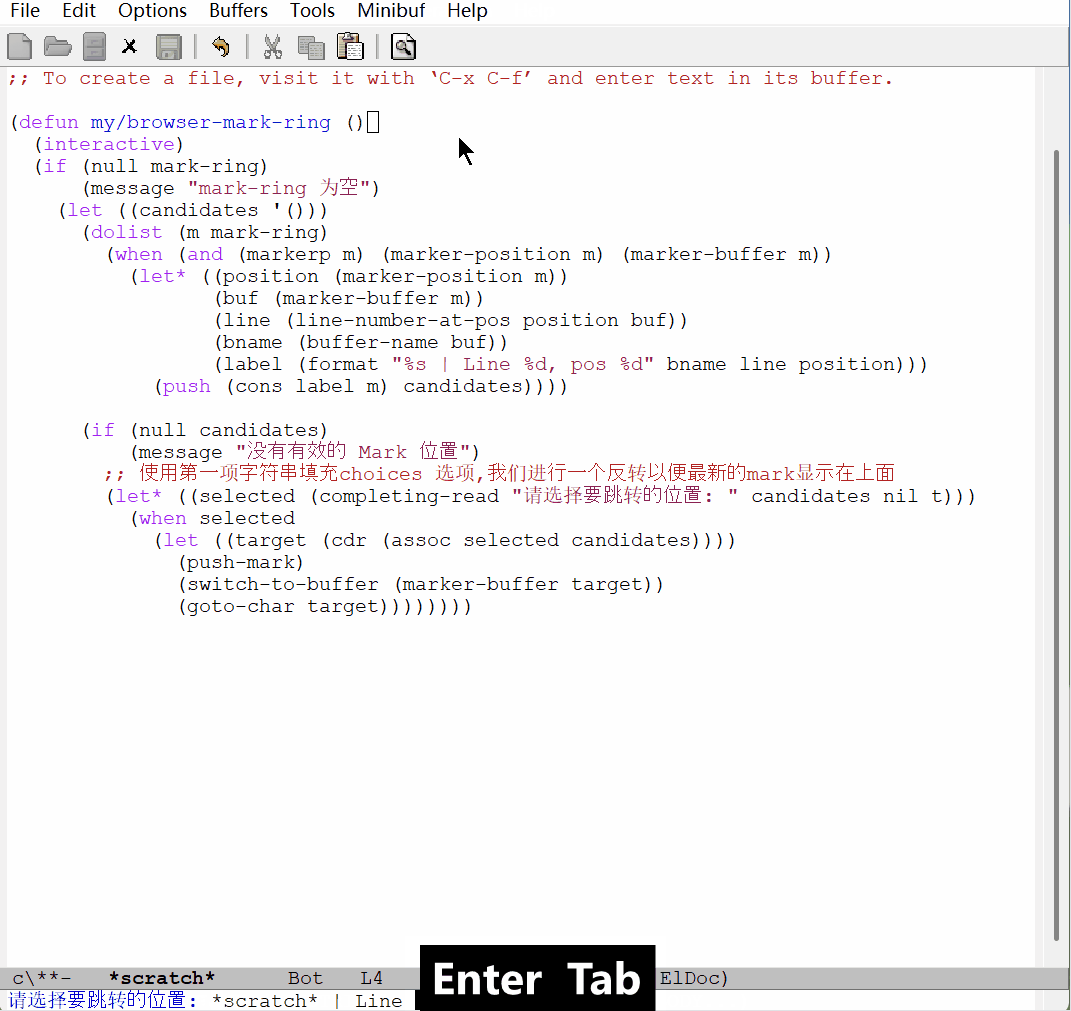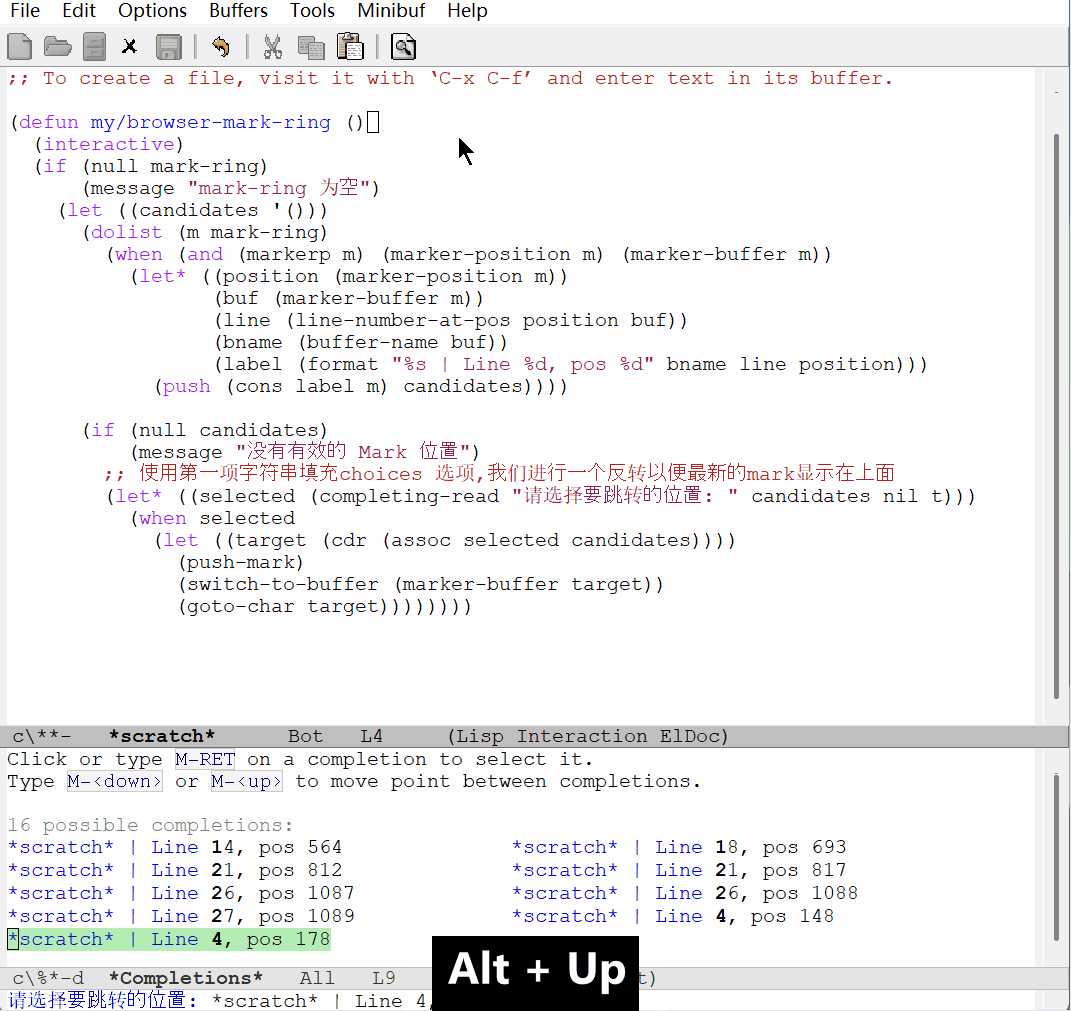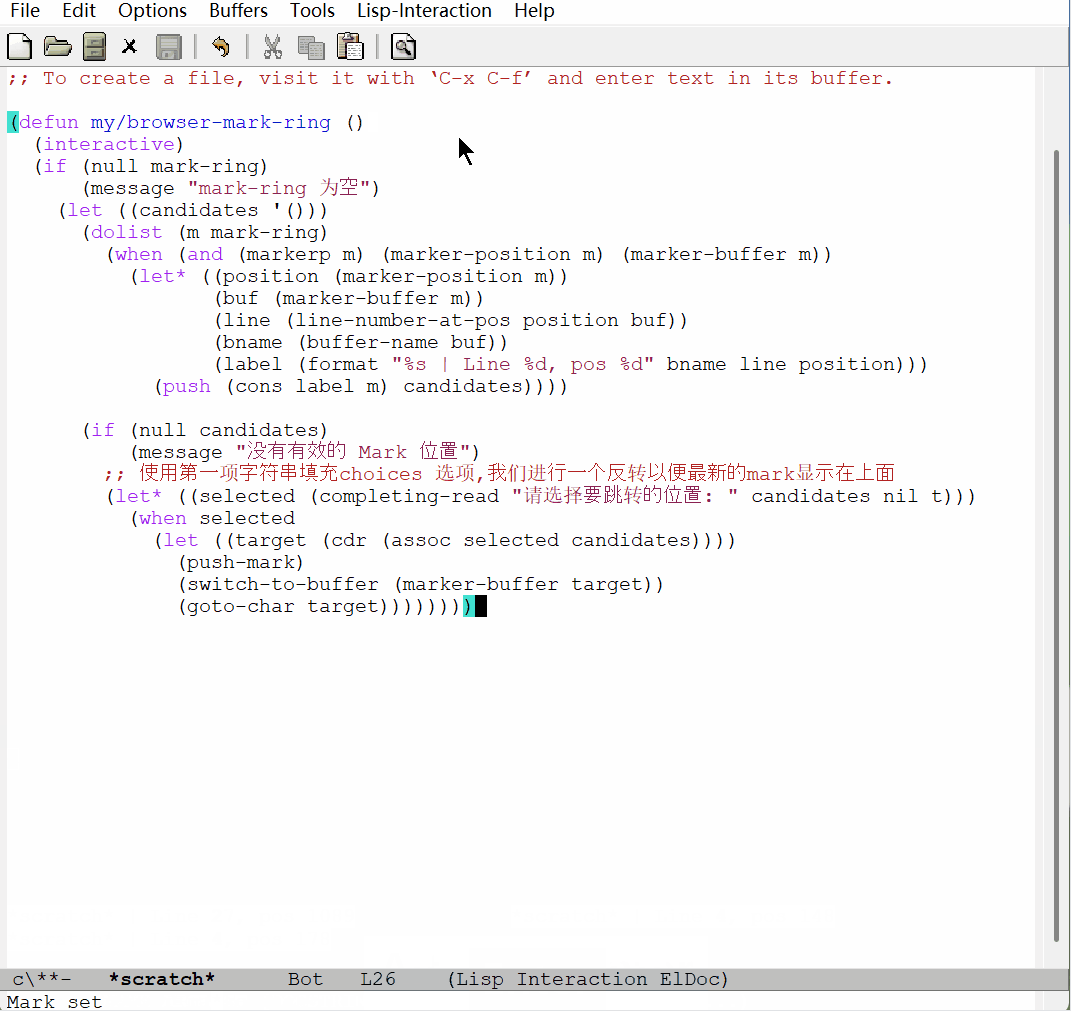
《elisp 每日一练》——Mark Ring 在前面我们了解了 mark 的机制以及通过 mark 和 point 来组成region,这次我们将深入了解 Emacs 是如何 管理 mark 的。背景知识铺垫我们通过 push-mark 和 pop-mark 来管理mark。根据这两个名词我们可能会认为Emacs 是通过栈来管理的,push-mark 表示压栈而 pop-mark 表示出栈。其实Emacs管理mark的真实手段确实遵循后进先出的栈规则,但是pop-mark 并不会从栈结构中删除对应的mark记录。想象一下这个场景:我们之前记录了 A、B位置,现在又记录了C位置,如果我想回到上一次的B位置,要通过 pop-mark 让C位置出栈,但是如果后续我又想回到C位置怎么办呢?如果出栈的时候销毁了数据就回不来了。所以实际上 push-mark 会放入新的mark但是 pop-mark 只会改变指向栈顶的位置。并且可以在A、B、C之间循环也就是可以从C回到A。考虑到这些场景,我们能想到应该是一个环形的链表,或者是一个首尾相连的数组,构成一个环形的数据结构。这也就是 Mark Ring 这个名称的由来。实际上mark ring 并不能无限增长,它有一个大小的上限, 通过变量 mark-ring-max 指定,一般默认的是16。如果 ring 的长度超过了 mark-ring-max , 最旧的一个会被抛弃。我们还是以A、B、C三个位置来举例说明每次 push-mark 和 pop-mark 之后,Emacs 如何组织环。首先调用 (push-mark A) 来入栈A位置,此时栈的值为 '(A)结着调用 (push-mark B) 来入栈B位置,此时栈的值为 '(B A)然后调用 (push-mark C) 来入栈C位置,此时栈的值为 '(C B A)如果要回到C位置,直接调用 (goto-char (mark)) 此时栈不变如果要回到B位置, 先调用 (pop-mark) ,Emacs 会取出C的值,然后放到列表的尾部,此时整个栈会变成 '(B A C)如果要回到A位置,与上面类似,先出栈,Emacs会改变栈数据,变为 '(A C B)所以说我们如果想要回到上一步一个办法是不断调用 pop-mark 使对应位置。另一个办法就是回归 mark-ring 的本质,我们在 C/C++ 语言中可以通过数组的方式来实现,但是在Emacs Lisp中,它就是一个列表。我们可以通过操作列表方式来做到这点。实际上,Emacs 通过 mark-ring 这个变量记录着当前所维护的栈。我们可以通过 describe-variable 来查看变量,并结合push-mark 和 pop-mark 函数来观看每次改变之后具体的变量值来观察上述过程。另外,Emacs 实际维护了两组 mark-ring,一组是与buffer相关的,一组是全局的。这个很好理解,如果我们要在多个buffer中进行跳转,自然使用全局的 global-mark-ring 。但是我们并不需要特别的执行global-push-mark 这样的函数来操作全局,实际上也没有这个函数。当我们执行 push-mark 时Emacs会自己考虑是否要加入 global-mark-ring。也就说我们通过 push-mark 和 pop-mark 任意操作,Emacs会保证我们能正确记录。一个好的习惯是涉及到大范围的光标转移不要直接使用 goto-char 就完事了,而是要考虑后续是否需要回来,也就是提前调用 push-mark 记录一下。练习有了这些知识作为铺垫,我们今天来做一个相对复杂一点的练习。我们写一个函数,它主要功能如下:在minibuffer 中列举 mark-ring 中的值,以buffer名称、行号和 point 值的形式显示用户在选择某一项之后跳转到当前位置本次练习我们用到的函数和变量如下:mark-ring:记录当前所有保存的mark记录marker-position : 获取当前mark记录的point位置line-number-at-pos : 计算当前point 在buffer的第几行marker-buffer : 获取当前 mark 记录的buffer 对象buffer-name: 获取对应buffer 的名称前面几个函数比较简单,我们看名称和用法大概能知道怎么用,下面我们重点介绍一个与minibuffer相关的函数: completing-read它的函数原形如下:(completing-read PROMPT COLLECTION &optional PREDICATE REQUIRE-MATCH INITIAL-INPUT HIST DEF INHERIT-INPUT-METHOD)它用来弹出一个minibuffer的补全菜单,根据用户选择返回对应选项的字符串。PROMPT 是提示词,用于提示用户这个菜单是干什么用的。COLLECTION 是一个列表,它可以存储字符串或者以字符串为 key 的列表/哈希表/符号表,我们这里可以构建一个每项都是 '(提示词 . mark对象) 的关联CELL,后续根据用户选择所关联的 mark 进行跳转至此我的实现思路如下:遍历 mark-ring 取出其中的每个marker针对 marker 调用函数获取buffer名称、行号、位置等信息根据上述信息组织字符串并组成一个 '(字符串 . mark对象) 的关联CELL将关联CELL传入 completing-read,弹出提示根据用户选择提示,获取返回选中的字符串根据字符串查找关联的 mark 对象最后执行 goto-char 跳转到mark对象所对应的位置以下是我实现的代码:(defun my/browser-mark-ring () (interactive) (if (null mark-ring) (message "mark-ring 为空") (let ((candidates '())) (dolist (m mark-ring) ;; 遍历列表 (when (and (markerp m) (marker-position m) (marker-buffer m)) (let* ((position (marker-position m)) (buf (marker-buffer m)) (line (line-number-at-pos position buf)) (bname (buffer-name buf)) (label (format "%s | Line %d, pos %d" bname line position))) ;; 组织对应数据结构 (label . marker) (push (cons label m) candidates)))) (if (null candidates) (message "没有有效的 Mark 位置") (let* ((selected (completing-read "请选择要跳转的位置: " candidates nil t))) (when selected (let ((target (cdr (assoc selected candidates)))) (push-mark) (switch-to-buffer (marker-buffer target)) (goto-char target))))))))最终它的效果如下:总结本篇我们详细了解了 mark-ring 的机制,它就是一个列表,我们可以通过操作列表的方式操作它。并且Emacs自己为每个buffer维护了专属的 mark-ring 和通用的全局 global-mark-ring另外通过这个例子我们知道下面几个函数:mark-ring:记录当前所有保存的mark记录marker-position : 获取当前mark记录的point位置line-number-at-pos : 计算当前point 在buffer的第几行marker-buffer : 获取当前 mark 记录的buffer 对象buffer-name: 获取对应buffer 的名称completing-read : 负责与minibuffer 交互并返回选中的字符串值
-
《elisp 每日一练》—— Region 在关于保存和恢复现场的例子中,我们了解了 marker 相关的概念。 marker 与 point 都是一个表示位置的整数,不同的是marker 是动态的,由Emacs 内部根据buffer内容变化进行维护,而 point 是静态的。它们两个结合可以构成我们今天要讨论的内容——Region知识铺垫在图形界面编辑器中,我们经常用鼠标拖拽高亮一段文字,这叫“选中文本”。而在 Emacs 中,这个概念叫 Region(选区)。Region 是一个区间,它由 marker 和 point 组成的闭区间。我们可以使用这样一个公式来描述区间的组成: $\text{Region} = [\min(\text{point}, \text{mark}), \max(\text{point}, \text{mark})]$也就是说,起始位置是从 marker 和当前 point 中找到最小值,终点位置是二者的最大值。所以我们需要注意,在编写有关 Region 的代码时绝对不能假设使用 marker 或者 point 作为起点,或者终点。实际上为了解决这个问题,Emacs 提供了两个函数 region-beginning 和 region-end 来获取Region的开始和结束位置我们如何激活一个区域呢?可以通过 activate-mark 函数来激活当前选取。又或者可以通过 push-mark 在创建 marker 的同时进行激活。实际上 push-mark 的函数原形为:(push-mark &optional LOCATION NOMSG ACTIVATE)后面几个参数是可选的,它们分别代表:LOCATION: 表示作为新 marker 位置的 point 值,默认是当前光标所在位置NOMSG : 是否在minibuffer 中显示 Mark set 字样, 默认为 nil 也就是不显示ACTIVATE : 是否激活当前 Region,默认为 nil 不激活我们可以用一个例子测试一下(defun my/select-whole-buffer() (interactive) (goto-char (point-min)) (push-mark (point-max) nil t))上述例子我们将整个buffer的内容进行全选。另外,在操作 Region 时我们经常需要判断当前 Region 是否出于激活状态。因为前面介绍过实际上 marker 和 point 天然就构成一个 Region。如果不进行判断,用户想要进行某些操作时会出现不可预料的情况。例如如果用户想在选中区域进行查找,或者在当前行查找,如果不进行判断,有可能用户没有进行选区操作但是查找时却因为隐藏的region 导致查找发生在region中我们可以通过 use-region-p 来判断用户是否激活了选取练习我们实现一个函数,如果用户选择了一个区域,那么将区域中的所有字母大写,否则将光标所在单词的字母转换为大写。将单个单词大写可以使用函数 upcase-region,而将单词大写可以使用 upcase-word。upcase-region 接收一个起始位置和结束位置,将这个区间内的字母都转化为大写upcase-word 接收一个整数,表示将光标所在位置之后(正数)、或者之前(负数参数)的多少个单词转化为大写upcase-word 仅仅只能将光标所在位置到单词结尾位置的字母大写,我们还需要一个方法来获取单词首部,然后通过 goto-char 的方式移动光标到词首,最后执行 upcase-word。当然有了范围也可以使用 upcase-region获取光标所在单词的范围可以使用 bounds-of-thing-at-point。他的函数原形如下:(bounds-of-thing-at-point THING)它支持的 THING 非常多,有 word 、list、symbol、number、filename 等等。这里我们使用 word 就行。它返回的格式是 (START . END)。结合之前介绍的CELL的操作就可以获得START 的值。我们可以做一个快速选择光标所在单词的函数来看看它的用法(defun my/select-the-word() (interactive) (let ((bound (bounds-of-thing-at-point 'word))) (progn (goto-char (car bound)) (push-mark (cdr bound)) (activate-mark))))这里我们确实需要改变mark栈来和当前光标位置组成一个新的区域,所以不适合使用 save-excursion 来保存和还原现场。另外这里也演示了如何通过 activate-mark 来激活一个选区。有了这些函数的辅助,最终我的实现如下:(defun my/upcase-target() (interactive) (if (use-region-p) ;;用户选中区域,转换区域内文本 (upcase-region (region-beginning) (region-end)) ;;用户未选中文本,直接转换单词 (save-excursion ;; 考虑保存和恢复现场 (let ((bound (bounds-of-thing-at-point 'word))) (if bound (progn (goto-char (car bound)) (upcase-word 1)))))))至于如何使用 upcase-region 来实现将光标所在单词转化为大写的功能,读者可以自行尝试。总结本篇我们了解了 Region 的概念,以及可以使用Region做一些事情。后续很多高级的功能都可以依赖region 来实现,例如在选区中搜索、替换文本。今天介绍的函数有:region-beginning 和 region-end 获取选区的区间activate-mark 激活选区use-region-p 判断选区是否激活upcase-word 将光标所在位置之后的单词转化为大写upcase-region 将对应区间的单词转化为大写bounds-of-thing-at-point 获取指定事物所在的区间
-
《elisp 每日一练》——现场保护与还原 在第二天里面,我们介绍了光标移动和行索引区间的api函数,并且学会了如何移动光标。实际上在操作Emacs进行文本编译的动作时很多时候都在移动光标,只是我们感觉不到。如果我们随意的移动光标就容易带来一个问题,我们执行某个操作之后找不到光标在哪了,如果我们还要花时间找光标在哪,就很浪费效率背景知识铺垫如果我们自己实现一个简单的版本,我们可能会考虑使用 let ((old-point (point))) 这样的语句来先保存最后通过 (goto-char old-point) 来进行设置。这个思路是对的,但是它主要的问题是point记录的是当前位置的索引,如果我们在当前光标位置之前插入了字符串改变了光标所在文本的索引,那么根据之前保存的位置值就是一个错误的值。为了解决上一个问题,Emacs引入了 marker 的概念。与 point 不同,marker 是指向 Buffer 中特定位置的指针。如果在 Marker 之前插入或删除了文本,Emacs 的 C 语言底层会自动更新 Marker 的数值,使其依然指向原本对应的那个文字点。我们可以通过 push-mark 和 pop-mark 来保存和恢复一个mark。从名字上可以看出来它是一个栈操作。需要注意的是,出栈时并不会返回栈顶存储的值,我们可以通过 mark 函数来获取栈顶的值。为了清楚的体现第二个区别,我们可以写这样一个例子(defun my/test-point() (interactive) (let ((old-point (point))) (goto-char (point-min)) (insert "this is a test for point") (goto-char old-point))) (defun my/test-mark() (interactive) (push-mark) (goto-char (point-min)) (insert "this is a test for point") (goto-char (mark)) ;; 通过栈顶记录的marker 值来恢复光标位置 (pop-mark))到这里我们似乎解决问题了。我们可以通过管理marker 栈来实现保存和恢复现场。但是我们没有考虑一种情况:如果在push 之后 pop 恢复之前程序出错了,怎么办?我们要为这段代码加一个异常处理机制。到这里我们就可以请出今天的主角了—— save-excursion 。这是一个用C实现的底层函数,用于保证在任何情况下都能恢复现场。你可以将它理解为底层通过try catch 包装了的 push-mark 和 pop-mark。根据这点我们可以知道它需要注意的点:它只用来还原光标现场,而不会还原中间对文本执行的插入、删除操作避免在大的循环中使用,多次进行 push-mark和 pop-mark 会不断制造和销毁临时的marker资源,影响性能它的定义如下:(save-excursion &rest BODY)我们可以将上面的例子做一个改动(defun my/test-mark() (interactive) (save-excursion (goto-char (point-min)) (insert "this is a test for marker")))有了这个函数,我们能从繁琐的现场保存与恢复中解放出来,将注意力集中在具体功能的实现上。练习这次的练习比较简单,我们就简单的为上一次的复制行的函数加一个恢复现场的功能(defun my/duplicate-current-line() (interactive) (save-excursion (let ((line-next (buffer-substring (line-beginning-position) (line-end-position)))) (goto-char (line-end-position)) (newline) (insert line-next))))总结本篇我们讨论了Emacs中保护和还原现场,提到了 marker 和 point。同时也引入了 save-excursion 来保护和还原现场。既然本篇章提到了 marker,Emacs中 marker 和 point 组成了一个很重要的概念—— region。一般我们叫它选区,也就是在编辑器中我们看到的用户选中区域。这部分内容将在后面进行介绍。
-
《elisp每日一练》——行定位与光标移动 在第一天,我们知道buffer实际上就是一个存储文本信息的缓冲区,而光标所在位置就是缓冲区中当前字符的索引。并且这个缓冲区有一个最大索引和最小索引。除非我们要对整个缓冲区进行清空、全选、移动到开头或者结尾位置等操作,一般来讲我们用到全缓冲区的操作并不多,更多的是快速移动光标然后插入字符或者在行间进行跳转。所以今天我们主要介绍行操作和光标移动背景知识铺垫依靠光标所在位置可以定位当前行所在的索引区间,通过函数 line-beginning-position 和 line-end-position 来获取前行行首或行尾的 Point 位置。但是和它们第一天介绍的 point 等函数类似,只是获取对应的索引位置,并不会改变光标位置。如果要改变光标位置,通过 goto-char 来实现依靠这些知识,我们实现一个移动到下一行或者上一行的函数(defun my/goto-next-line() (interactive) (let* ((next-start (+ 1 (line-end-position))) (next-start (min next-start (point-max)))) (goto-char next-start)))上述实现的思路就是通过 line-end-position 定位到当前行尾的下一个位置。但是需要考虑是否是最后一行了。最后再通过 goto-char 移动光标到对应位置。如果我们通过循环或者递归的方式调用该函数就可以实现连续向下移动N行。但是这个功能Emacs也提供了,它的函数名为 forward-line。如果传入的参数N为正数则往下移动N行,为负数则表示向上移动N行。练习在vim中,我们常用的操作是 yy 拷贝当前行然后 p/P 粘贴到下一行或者上一行。今天的练习我们来尝试实现这么一个功能,为了简单我们就不支持拷贝多行了。我们可能用到的API函数有:line-beginning-position 和 line-end-position 用来定位范围buffer-substring 用来拷贝字符串goto-char 移动光标位置newline 插入新行insert 用来在光标所在位置插入字符有了这些铺垫,我们可以实现这个函数了(defun my/duplicate-current-line() (interactive) (let ((line-next (buffer-substring (line-beginning-position) (line-end-position))) ;拷贝当前行所在字符 ) (goto-char (line-end-position)) (newline) ;; 插入新行 (insert line-next)))总结本篇介绍了行操作有关的api函数。并且实现了一个简单的复制当前行到下一行的函数。但是这个例子不太完美,因为我们发现执行玩之后光标停留在下一行的行尾位置,如果我们不希望改变光标位置,让它停留在当期行该怎么办呢?下一篇我们将解决这个问题,来讨论如何恢复现场